작성 기준: 2026년 11월 2일. 공식 문서에서 확인한 기능의 범위와 이 글에서 제안하는 검증 설계를 구분합니다. 예시는 가상 문서이며, 유료 API를 실행하거나 모델별 정확도를 측정한 결과는 아닙니다.
파싱 성공은 자동화의 시작이다
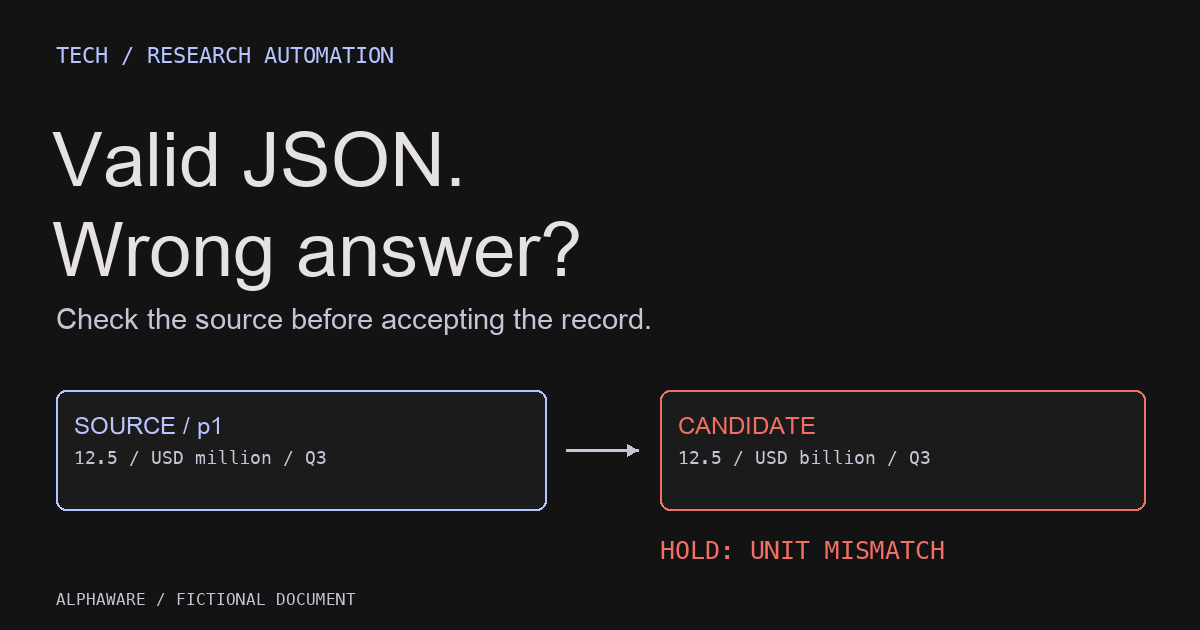
리서치 문서에서 숫자를 뽑는 작업을 LLM에 맡겼다고 해 봅시다. 응답이 JSON이고 value가 숫자이면 데이터베이스에 넣어도 될까요? 문서에 있는 12.5 million을 모델이 12.5 billion으로 옮겨도 자료형은 맞습니다. 전분기 수치를 이번 분기 칸에 넣어도 마찬가지입니다.
구조화 출력은 필요한 기술입니다. 다만 형식이 맞는 결과를 받는 일과 원문에 맞는 결과를 받는 일은 다른 검사입니다. 잘못된 숫자를 안정적으로 저장하는 시스템도 문법 검사만 보면 정상입니다.
Anthropic 문서는 JSON 출력을 스키마에 맞추는 기능과 엄격한 도구 입력 검증을 구분해 설명합니다. 지원하는 JSON Schema의 범위와 예외도 따로 명시합니다. 이 기능을 채택해도 업무상 의미와 출처까지 자동으로 검증된다고 해석해서는 안 됩니다. 구조화 출력 공식 문서
세 단계로 나눠야 실패 이유가 보인다
이 글에서 제안하는 흐름은 문법, 업무 규칙, 근거의 순서입니다.
| 검사 | 확인할 것 | 통과해도 남는 문제 |
|---|---|---|
| 형식 | JSON 파싱, 필수 필드, 자료형, 허용 필드 | 숫자·내용이 원문과 다를 수 있음 |
| 업무 규칙 | 단위, 기간, 범위, 필드 간 관계 | 그럴듯하지만 근거 없는 값일 수 있음 |
| 근거 대조 | 등록된 문서·구절·값과의 일치 | 원문 자체의 오류나 해석 문제 |
JSON Schema의 required와 additionalProperties는 필수 키와 추가 키 허용 여부를 표현하는 도구입니다. 문서에 적힌 매출이 정확한지 판단하는 장치는 아닙니다. 공급자 지원 범위와 별개로 애플리케이션에서도 입력을 검증해야 합니다. JSON Schema 객체 설명
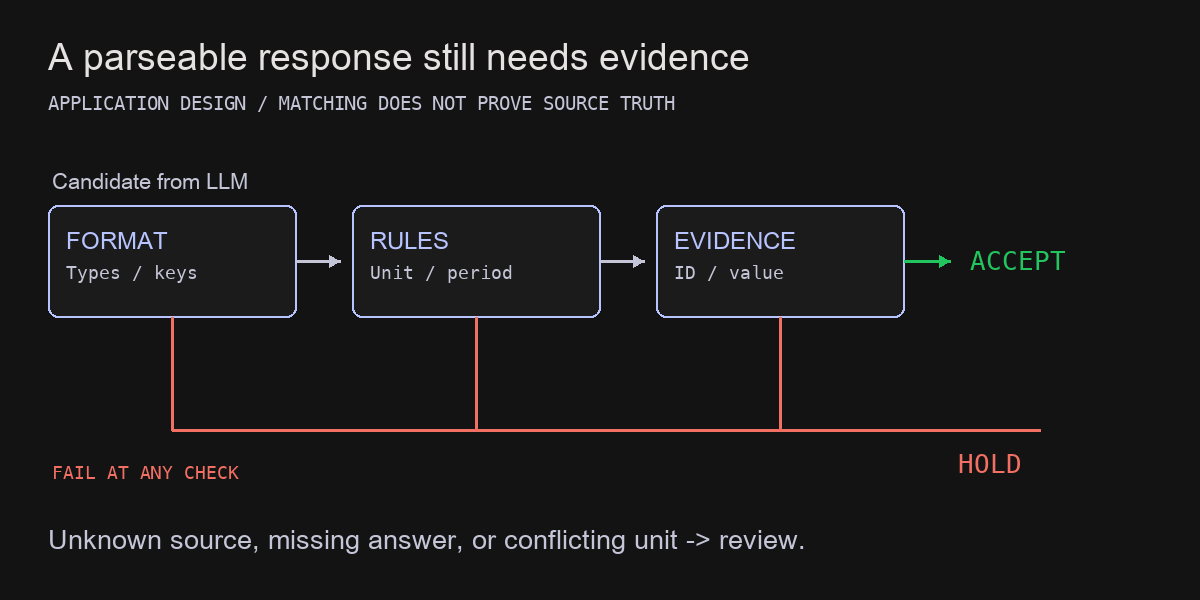
직접 그린 설계도. 어느 검사에서든 실패하면 저장을 보류합니다. ‘근거 확인’은 원문과의 일치이며 원문 자체의 진실성을 보장하지 않습니다.
URL을 생성시키기보다 근거 ID를 선택하게 한다
모델에게 출처 URL을 자유롭게 쓰게 하면 존재하지 않는 경로나 엉뚱한 페이지가 나올 수 있습니다. 대신 수집 단계에서 문서 ID와 구절 ID를 만들고, 모델은 전달받은 목록의 ID만 반환하게 설계할 수 있습니다. URL, 수집 시각, 원본 해시는 애플리케이션이 관리합니다.
가상의 입력 문서 demo-report에 검토자가 확인한 레코드가 하나 있다고 합시다.
{
  "passage_id": "p1",
  "quote": "Revenue for Q3 was USD 12.5 million.",
  "metric": "revenue",
  "period": "Q3",
  "value": "12.5",
  "unit": "USD million"
}
이 레코드는 LLM 응답으로 새로 만든 정답표가 아닙니다. 원문과 대조해 사람이 확인했거나 신뢰할 수 있는 파서로 만든 비교 기준이라는 가정입니다. 같은 모델이 만든 추출값을 같은 모델이 만든 정답과 비교하면 독립 검증이 되지 않습니다.
모델의 역할은 여러 구절 가운데 질문에 맞는 레코드를 선택하고 지정한 형태로 제안하는 데 둡니다. 존재하지 않는 ID는 거부합니다. 인용문이 실제 원문에 있는지도 확인하되, 문자열이 있다는 사실만으로 그 문장이 모델의 해석을 지지한다고 볼 수는 없습니다. 부정문, 표의 열 제목, 연결·별도 재무제표 구분은 별도 해석이 필요합니다.
최소 검증기는 이렇게 작동한다
다음은 API 호출 코드가 아니라, 이미 스키마를 통과한 추출 후보를 대조하는 Python 예시입니다. 문서 저장소의 evidence는 위 가정대로 독립적으로 확인됐다고 둡니다.
from decimal import Decimal, InvalidOperation

evidence = {
    ("demo-report", "p1"): {
        "metric": "revenue", "period": "Q3",
        "value": "12.5", "unit": "USD million",
        "quote": "Revenue for Q3 was USD 12.5 million.",
    }
}

def verify(candidate, registry):
    key = (candidate["document_id"], candidate["passage_id"])
    source = registry.get(key)
    if source is None:
        return "unknown_evidence"
    for field in ("metric", "period", "unit", "quote"):
        if candidate[field] != source[field]:
            return "evidence_mismatch"
    try:
        value = Decimal(candidate["value"])
        reference = Decimal(source["value"])
    except (InvalidOperation, TypeError, ValueError):
        return "invalid_number"
    if not value.is_finite() or not reference.is_finite():
        return "invalid_number"
    return "matched" if value == reference else "value_mismatch"

candidate = {
    "document_id": "demo-report", "passage_id": "p1",
    **evidence[("demo-report", "p1")],
}
assert verify(candidate, evidence) == "matched"
assert verify({**candidate, "unit": "USD billion"}, evidence) == "evidence_mismatch"
assert verify({**candidate, "value": "125"}, evidence) == "value_mismatch"
assert verify({**candidate, "passage_id": "p9"}, evidence) == "unknown_evidence"
금액은 문자열을 Decimal로 변환해 비교했습니다. 문자열 12.50과 12.5는 같은 수로 볼 수 있지만 million과 billion은 그대로 다르면 거부합니다. 단위를 자동 환산하려면 명시적인 변환 규칙과 별도 검증이 필요합니다. 이 예시는 모든 필드의 존재와 자료형이 앞 단계에서 확인됐다고 가정하므로, 외부 JSON을 곧바로 함수에 넣는 완성형 서버 코드는 아닙니다.
여기서 matched는 등록된 근거와 일치했다는 좁은 뜻입니다. 회계 정의가 맞는지, 문서가 최신인지, 공시 자체가 수정됐는지는 별도로 판단해야 합니다. 독립 정답을 만들 수 없는 자유 서술형 질문은 이 방식만으로 자동 승인할 수 없습니다.
재시도보다 먼저 실패를 분류한다
네트워크 시간 초과는 제한된 재시도 대상입니다. 하지만 출처가 없어서 답을 못 했다는 응답을 성공할 때까지 다시 요청하면, 근거 없는 답을 만들어 내도록 압박할 수 있습니다.
빈 문서, 미등록 출처, 단위 충돌, 근거 부족은 각각 상태로 남기고 저장을 보류합니다. API의 거절 응답이나 출력 길이 제한으로 끝난 응답도 정상 추출과 구분해야 합니다. Anthropic은 불확실성을 인정하게 하고, 인용 근거와 주장을 확인하는 방식을 환각 완화 수단으로 안내합니다. 환각이 완전히 사라진다는 보장은 아닙니다. 환각 완화 안내
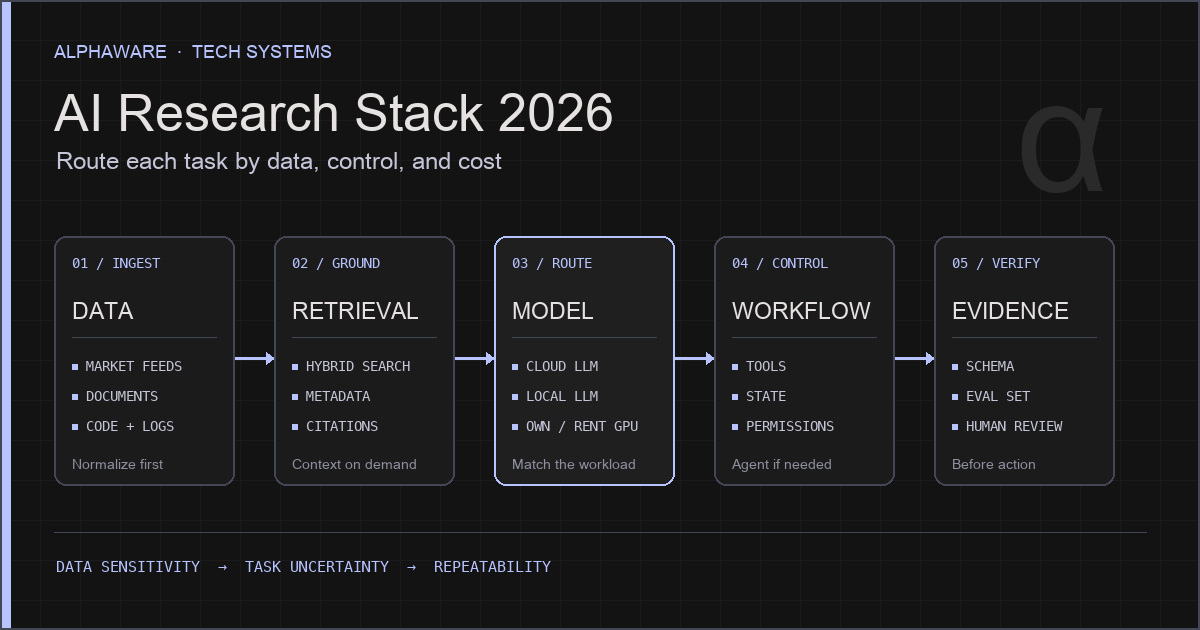
검증을 통과한 레코드라도 외부 작업 권한을 바로 주지는 않습니다. 추출과 검토 결과를 저장하는 작업, 보고서를 발행하는 작업, 거래 주문을 넣는 작업은 서로 다른 권한과 승인 조건이 필요합니다. 이 구분은 기존 AI 리서치 스택 칼럼의 검증 계층을 구체화한 것입니다.
모델을 바꿀 때 함께 볼 지표
평가 세트에는 정상 문서뿐 아니라 수치가 없는 문서, 같은 숫자가 다른 기간에 나오는 문서, 단위가 섞인 표를 넣습니다. 사람이 먼저 정답과 보류 조건을 정한 뒤 같은 세트로 모델·프롬프트·파서를 비교합니다.
- 형식 통과율: 전체 요청 중 스키마에 맞게 처리된 비율.
- 정답 일치율: 답할 수 있는 문서 중 값·단위·기간을 모두 맞힌 비율.
- 보류 정확도: 답이 없는 경우 보류했는지, 답이 있는 경우 과도하게 보류하지 않았는지 각각 측정.
- 잘못된 승인율: 승인된 레코드 중 정답과 다른 비율.
- 승인 건당 비용·지연: 실패·재시도·검토 비용까지 포함한 처리 부담.
분모와 평가 문서 수를 함께 기록해야 숫자를 비교할 수 있습니다. 이 글에서는 해당 평가를 실행하지 않았으므로 특정 모델이 더 정확하거나 저렴하다는 순위를 제시하지 않습니다.
자동화를 시작할 때는 한 종류의 문서와 한 필드로 범위를 좁혀 보세요. 원문까지 따라갈 수 있고, 답이 없을 때 멈추며, 오류가 어떤 검사에서 잡혔는지 설명할 수 있다면 다음 필드로 확장할 기반이 생깁니다.
참고 자료
- Anthropic 구조화 출력: 형식 제약과 지원 범위.
- JSON Schema 객체: 필수 필드와 추가 속성 제어.
- Anthropic 환각 완화 안내: 불확실성, 인용, 근거 확인.
- 근거 레지스트리와 승인 지표는 이 글에서 제안한 애플리케이션 설계입니다.