Archive
기술 아카이브
AI/ML 시스템 구축부터 데이터 파이프라인까지의 실무 기록
 글 읽기기술
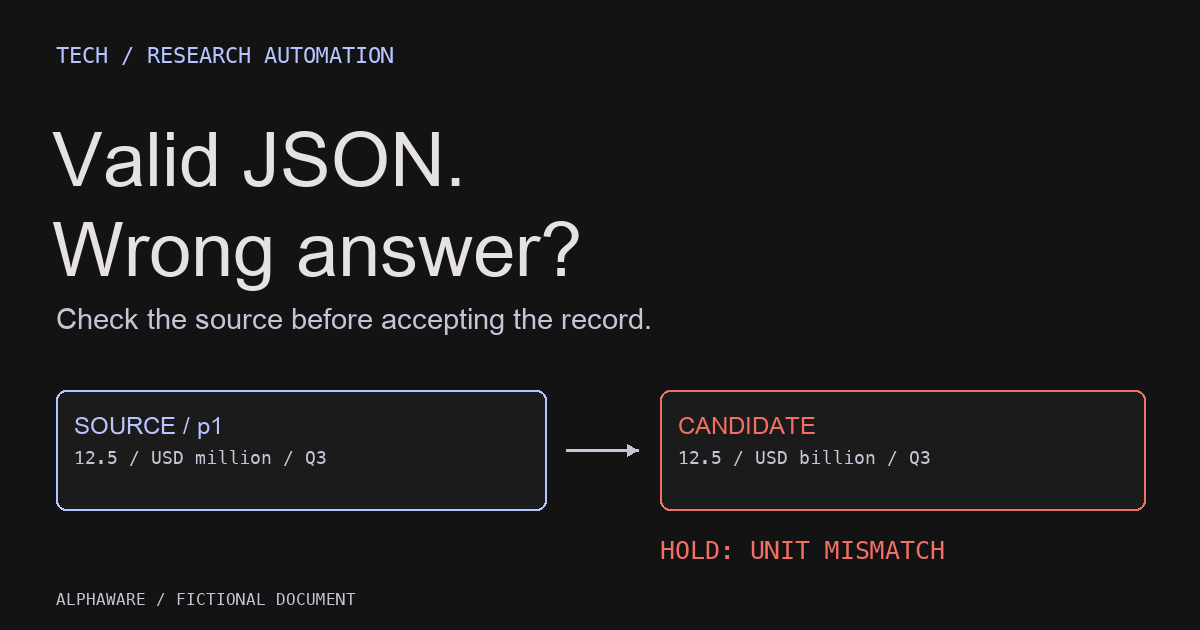
JSON이 맞아도 답은 틀릴 수 있다: LLM 출력의 근거 검증
구조화 출력의 형식 보장과 사실 검증을 구분하고, 출처 ID·단위·원문 대조와 실패 처리로 리서치 자동화의 오류를 줄이는 설계입니다.
 글 읽기기술
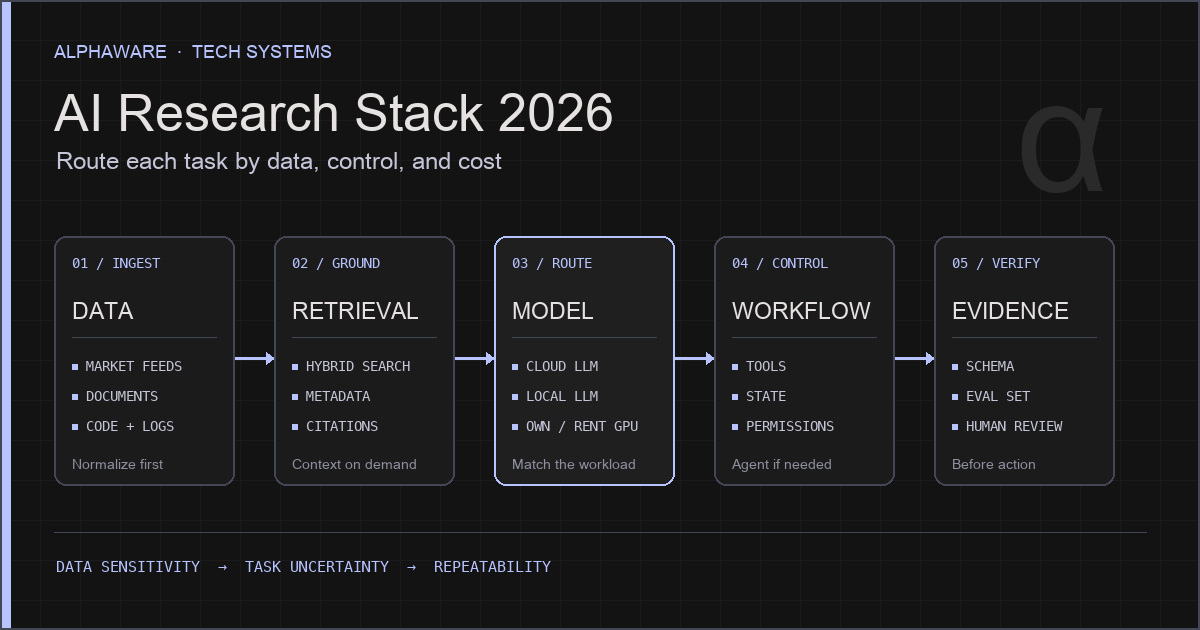
AI 리서치 스택 2026: 퀀트 리서치용 LLM 시스템을 층별로 설계하기
클라우드·로컬 LLM, RAG, 에이전트, GPU를 하나의 시스템으로 보고 데이터 민감도, 작업 불확실성, 검증 방법에 따라 각 작업의 경로를 정하는 설계 방법입니다.
 글 읽기기술
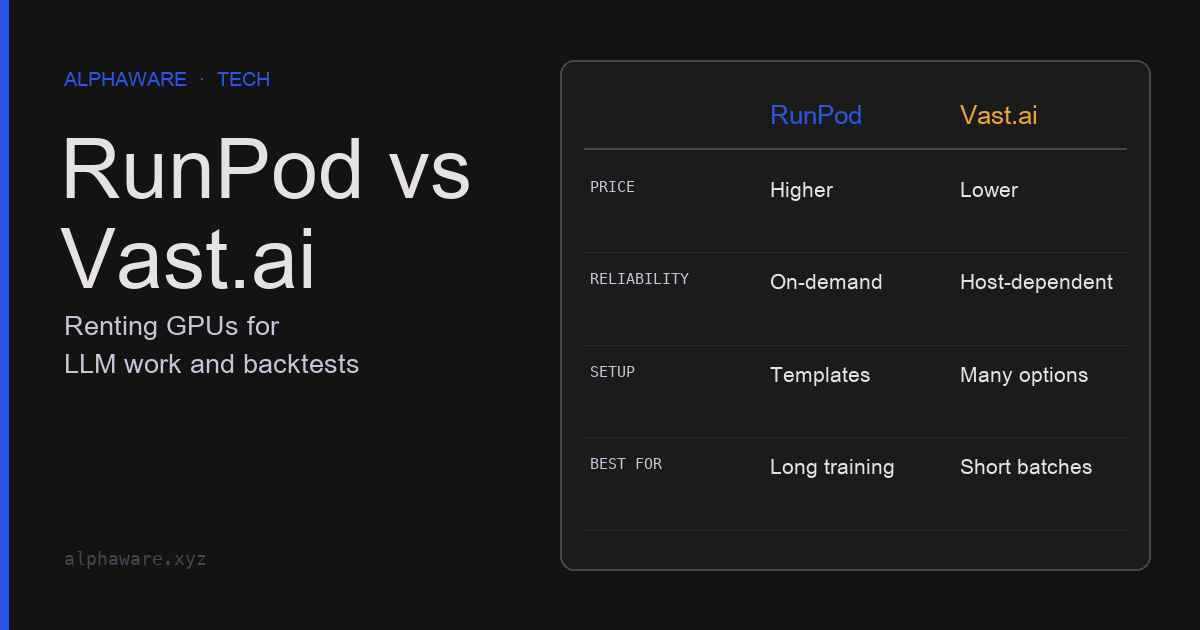
RunPod vs Vast.ai: GPU 임대 비용 구조와 작업별 선택 기준
RunPod와 Vast.ai의 임대 유형, 중단 조건, 과금 단위, 스토리지·데이터 전송 요금을 공식 문서로 비교하고, 로컬 LLM 실험·학습·배치 백테스트에 맞는 선택 기준을 정리합니다.
 글 읽기기술
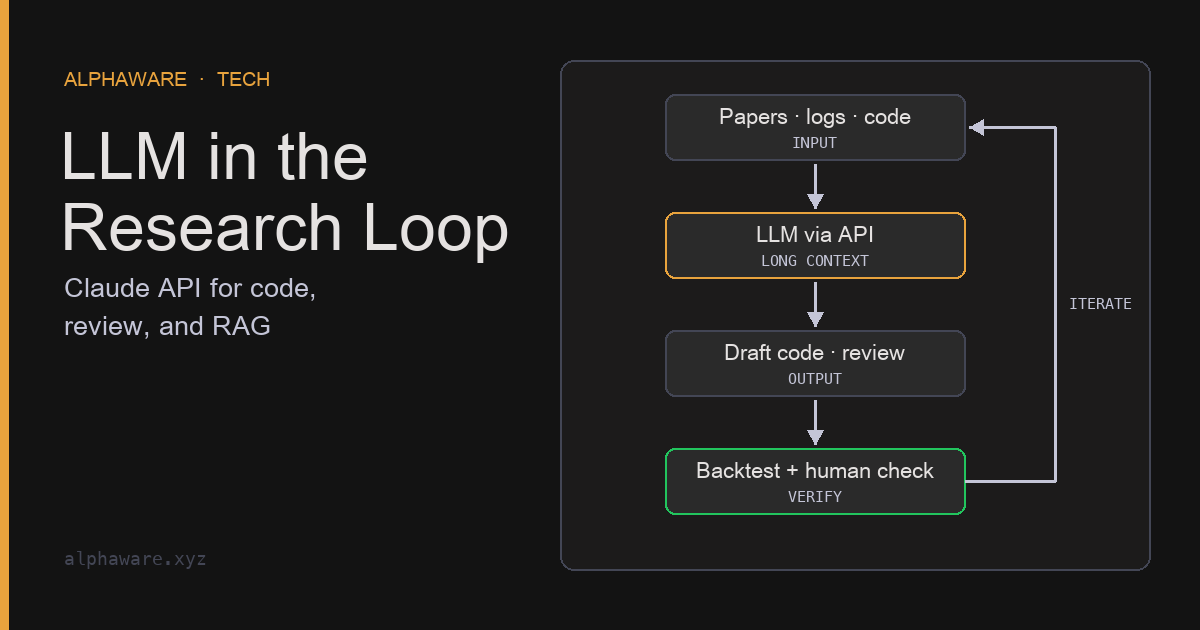
Claude API로 퀀트 리서치 자동화하기: 모델보다 먼저 정할 기준
모델 이름 비교 대신 작업 형태, 컨텍스트 길이, 배치·캐시 비용 구조, 구조화된 출력, 데이터 보존 조건으로 Claude API 도입을 설계하는 방법입니다.
 글 읽기기술
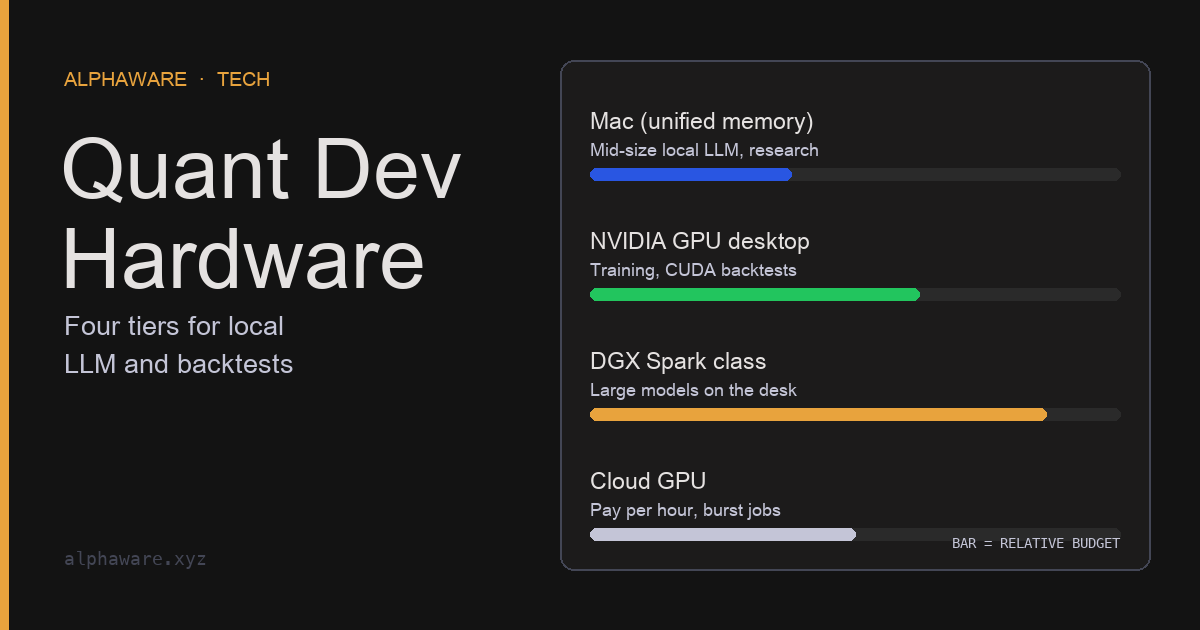
퀀트 개발 환경 고르기: GPU·Mac·DGX Spark를 작업 기준으로 비교하기
로컬 LLM, GPU 백테스트, 데이터 처리에 필요한 자원을 모델 메모리, 메모리 대역폭, CUDA·Metal 지원 기준으로 나누고, NVIDIA GPU·Apple Silicon·GB10 시스템과 클라우드 임대의 경계를 공식 사양으로 정리합니다.
 글 읽기기술
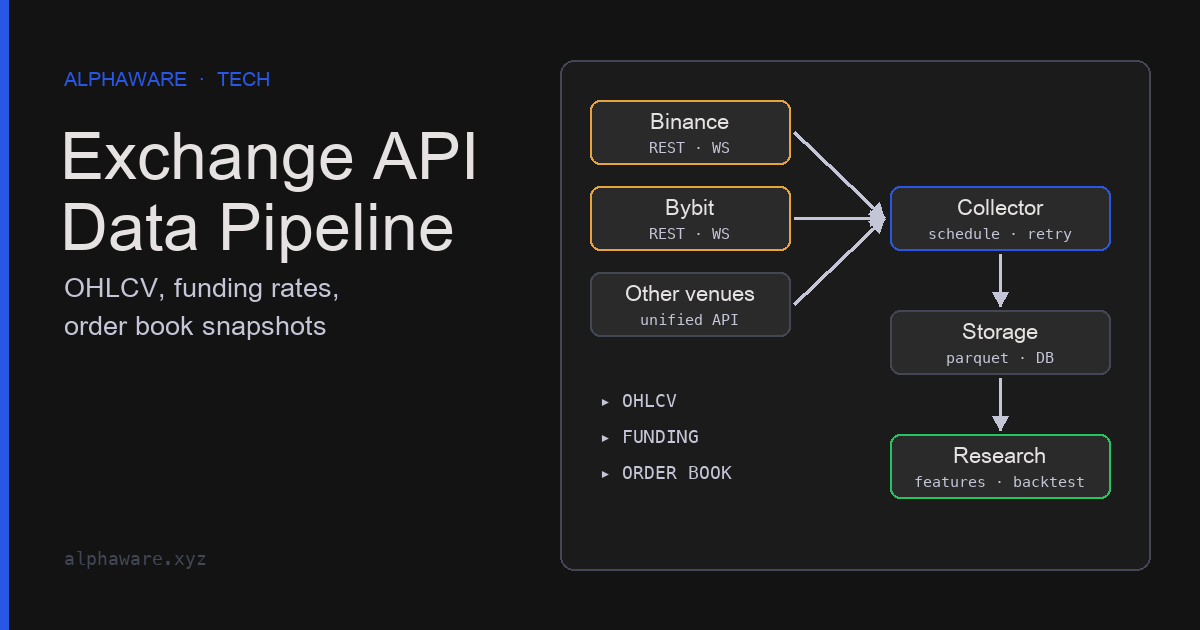
크립토 거래소 API로 시장 데이터 수집하기: Binance·Bybit 요청과 파싱 검증
Binance와 Bybit 공개 시장 데이터 API에서 캔들, 펀딩레이트, 오더북을 받을 때 문서와 맞춰야 할 엔드포인트·파라미터·레이트 리밋과, 오프라인에서 검증할 수 있는 파싱 코드를 정리합니다.
 글 읽기기술
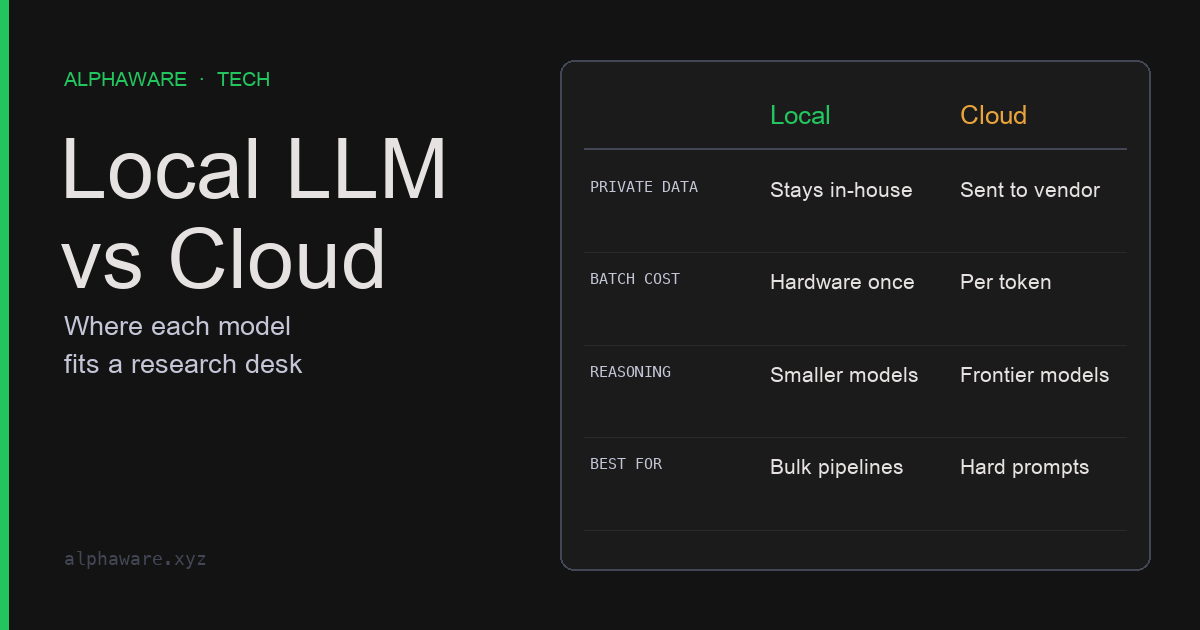
로컬 LLM과 클라우드 API, 퀀트 리서치에서 나누는 기준
데이터 경계, 가동률 기준 비용, 컨텍스트 설정, 출력 검증, 라우팅 규칙으로 로컬 모델과 클라우드 API의 역할을 나누는 방법입니다.