업데이트: 2026년 11월 3일. 제품 목록과 가격을 나열하던 글을 작업별 판단 기준으로 다시 썼고, 사양은 2026년 11월 3일 제조사 공식 페이지에서 확인했습니다. 가격과 구성은 자주 바뀌므로 구매 전에 아래 링크한 공식 페이지를 확인하세요.
장비보다 작업을 먼저 정한다
퀀트 개발 환경에서 병목이 되는 자원은 작업마다 다릅니다. pandas로 일봉 데이터를 다루는 작업은 거의 어떤 노트북에서도 돌아갑니다. 같은 “GPU가 필요한 작업”이라도 로컬 LLM 추론, 모델 학습, 몬테카를로 시뮬레이션은 서로 다른 사양에 막힙니다.
| 작업 | 먼저 막히는 자원 | 확인할 것 |
|---|---|---|
| 데이터 수집·정제, 일반 백테스트 | CPU 코어, 시스템 RAM, 디스크 | 데이터셋이 메모리에 들어가는지 |
| 로컬 LLM 추론 | 모델을 담을 메모리 용량, 메모리 대역폭 | 파라미터 수 × 정밀도, 문맥 길이 |
| 모델 학습·파인튜닝 | GPU 메모리, 프레임워크 지원 | CUDA 지원 여부, 옵티마이저 상태까지 포함한 메모리 |
| GPU 몬테카를로·그리드 서치 | 연산 정밀도 지원, 병렬도 | float64가 필요한지, 작업을 나눌 수 있는지 |
표에서 첫 행에 해당한다면 새 장비보다 코드와 데이터 형식(열 기반 저장, 필요한 열만 읽기)을 먼저 점검하는 편이 비용 대비 효과가 큽니다. 나머지 세 행은 아래 기준으로 나눠 봅니다.
모델 메모리는 파라미터 수와 정밀도로 먼저 계산한다
LLM 가중치가 차지하는 메모리는 대략 파라미터 수 × 파라미터당 바이트입니다. BF16·FP16은 2바이트, 8비트 양자화는 1바이트, 4비트는 0.5바이트입니다. RunPod 문서도 같은 경험칙으로 7B 모델에 약 14GB, 4비트 70B 모델에 약 35GB를 예로 듭니다. 여기에 문맥 길이에 비례하는 KV 캐시, 활성값, 런타임 여유분이 더해집니다.
BYTES_PER_PARAM = {"fp32": 4.0, "bf16": 2.0, "int8": 1.0, "4bit": 0.5}

def weight_gb(params_billion, precision):
    """가중치만의 메모리(GB). KV 캐시, 활성값, 런타임 여유분은 포함하지 않는다."""
    return params_billion * BYTES_PER_PARAM[precision]

def fits(params_billion, precision, memory_gb, overhead=1.2):
    """가중치에 20% 여유를 둔 단순 판정. 실제 여유분은 문맥 길이와 배치에 따라 다르다."""
    return weight_gb(params_billion, precision) * overhead <= memory_gb

def decode_ceiling_tps(params_billion, precision, bandwidth_gbs):
    """토큰마다 가중치를 한 번 읽는다고 본 이론 상한. 측정값이 아니다."""
    return bandwidth_gbs / weight_gb(params_billion, precision)

assert weight_gb(7, "bf16") == 14.0           # RunPod 문서의 7B ≈ 14GB 예시와 같다
assert weight_gb(70, "4bit") == 35.0          # 4비트 70B ≈ 35GB
assert not fits(70, "4bit", 32)               # 32GB 카드 한 장에는 가중치만으로도 넘친다
assert fits(70, "4bit", 128)                  # 128GB 통합 메모리에는 들어간다
assert round(decode_ceiling_tps(70, "4bit", 273), 1) == 7.8   # 273GB/s 기준 상한
이 계산은 가중치 기준의 하한입니다. 학습은 기울기와 옵티마이저 상태 때문에 추론보다 훨씬 많은 메모리가 필요하고, 정확한 값은 사용하는 프레임워크와 기법(LoRA 등)에 따라 달라집니다. 양자화는 메모리를 줄이지만 정확도 변화는 모델과 작업마다 따로 확인해야 합니다.
용량 다음은 메모리 대역폭이다
모델이 메모리에 들어간 다음에는 대역폭이 생성 속도의 상한을 정합니다. 토큰 하나를 생성할 때 가중치를 한 번 읽는다고 단순화하면, 초당 토큰 수의 이론 상한은 대역폭 ÷ 가중치 크기입니다. 실제 속도는 이보다 낮고, 배치·커널·양자화 형식에 따라 달라집니다. 그래도 같은 용량의 장비를 비교할 때 대역폭 차이는 크게 작용합니다.
| 장비(공식 사양) | 메모리 | 메모리 대역폭 |
|---|---|---|
| Mac mini (M6) | 16GB–32GB 통합 메모리 | 153GB/s 또는 170GB/s(구성별) |
| Mac mini (M5 Pro) | 24GB–64GB 통합 메모리 | 307GB/s |
| Mac Studio (M5 Max) | 36GB–128GB 통합 메모리 | 460GB/s 또는 614GB/s(구성별) |
| Mac Studio (M5 Ultra) | 96GB–512GB 통합 메모리 | 1.2TB/s |
| NVIDIA DGX Spark (GB10) | 128GB LPDDR5x 통합 메모리 | 273GB/s |
| GeForce RTX 5090 | 32GB GDDR7, 512비트 | 제품 페이지에 미표기 |
| GeForce RTX 4090 | 24GB GDDR6X, 384비트 | 제품 페이지에 미표기 |
Apple·NVIDIA 공식 사양 페이지 기준(2026년 11월 3일 확인). 메모리 상한은 구성별로 다르며, Mac은 일부 메모리 용량이 특정 칩 구성에서만 선택됩니다.
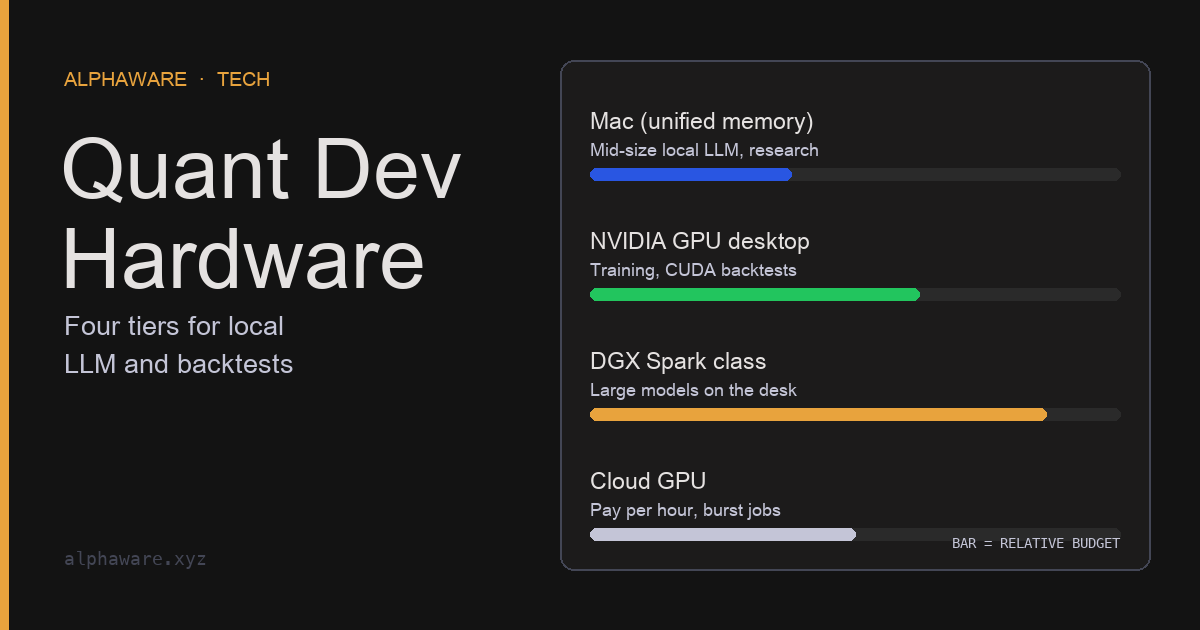
표에서 보이는 경계는 이렇습니다. 소비자용 GPU는 메모리 용량이 작은 대신 전용 GDDR 메모리를 씁니다. 통합 메모리 장비는 큰 모델을 한 장비에 담을 수 있지만, 대역폭은 칩 등급에 따라 크게 다릅니다. DGX Spark의 128GB는 큰 모델을 올리는 데 유리하지만, 273GB/s는 같은 표의 M5 Pro Mac mini(307GB/s)와 비슷한 수준입니다. 큰 모델을 “올릴 수 있다”와 “빠르게 생성한다”는 별개의 질문입니다.
프레임워크 지원이 성능표보다 먼저다
CUDA는 NVIDIA GPU에서 PyTorch, JAX 등 주요 학습 프레임워크가 기본으로 지원하는 경로입니다. 학습·파인튜닝이 주 작업이라면 NVIDIA 쪽이 선택지가 넓습니다. 새 아키텍처 GPU는 사용하는 프레임워크 빌드와 드라이버가 해당 GPU를 지원하는지 먼저 확인합니다.
Apple Silicon에서 PyTorch는 Metal 기반 MPS 백엔드(device="mps")로 GPU를 씁니다. PyTorch 문서에 따르면 MPS는 float64와 complex128을 지원하지 않고, 이런 텐서를 만들면 다운캐스팅 대신 오류가 납니다. 배정밀도가 필요한 수치 계산은 CPU에서 돌려야 합니다. 몬테카를로나 최적화 코드를 GPU로 옮길 계획이라면 이 제약을 먼저 확인합니다. 로컬 LLM 추론 도구는 Metal을 별도로 지원하는 경우가 많으므로, 쓰려는 도구의 문서에서 지원 여부를 확인합니다.
DGX Spark는 Arm CPU(20코어)에 Ubuntu 기반 DGX OS를 씁니다. x86용으로만 배포되는 바이너리나 패키지는 그대로 돌지 않을 수 있으므로, 의존성 목록에 aarch64 빌드가 있는지 확인합니다.
세 가지 장비 유형의 경계
NVIDIA 소비자용 GPU 데스크톱
학습과 CUDA 생태계가 필요할 때의 기본 선택지입니다. 한계는 카드당 메모리입니다. RTX 5090은 32GB, RTX 4090은 24GB이므로, 위 계산상 4비트 70B 모델의 가중치(약 35GB)는 카드 한 장에 들어가지 않습니다. 전력도 설계 조건입니다. NVIDIA는 RTX 4090의 그래픽 카드 전력을 450W, 권장 시스템 전력을 850W 이상으로, RTX 5090은 575W와 1000W(Ryzen 9 9950X 시스템 기준)로 제시합니다. 전원, 냉각, 케이스 공간을 함께 계획해야 합니다.
Apple Silicon Mac
통합 메모리 덕분에 큰 모델을 한 장비에 올리기 쉽고, 전력·소음 부담이 작습니다. 추론과 일상 개발에는 맞지만, CUDA 전용 학습 코드와 배정밀도 GPU 연산에는 맞지 않습니다. 모델 크기가 정해지면 위 표에서 그 크기를 담을 수 있는 칩 구성과 대역폭을 함께 고릅니다.
GB10 기반 소형 시스템(DGX Spark 등)
NVIDIA GB10 Grace Blackwell 칩, 128GB 통합 메모리, ConnectX-7(200Gbps) 네트워킹을 갖춘 150 × 150 × 50.5mm, 1.2kg 장비입니다. NVIDIA는 단일 장비에서 최대 200B 파라미터, 두 대 연결 시 최대 400B 파라미터 모델을 제시하고, AI 성능은 희소성을 적용한 이론 FP4 기준 최대 1 PFLOP으로 표기합니다. 이 수치는 저정밀도 기준이므로 FP16 학습 성능으로 읽으면 안 됩니다. Acer, ASUS, Dell, Gigabyte, HP, Lenovo, MSI가 GB10 기반 시스템을 판매하며, 저장 용량과 메모리 구성(일부 64GB 모델)은 제조사마다 다릅니다.
이 유형이 맞는 경우는 좁습니다. 데이터를 외부 클라우드에 보낼 수 없으면서 큰 모델을 상시 로컬에서 돌려야 하거나, CUDA 환경을 그대로 유지한 채 대용량 메모리가 필요한 경우입니다. 생성 속도가 중요하다면 앞 절의 대역폭 비교를 먼저 봅니다.
구매와 임대는 사용 시간과 데이터 조건으로 나눈다
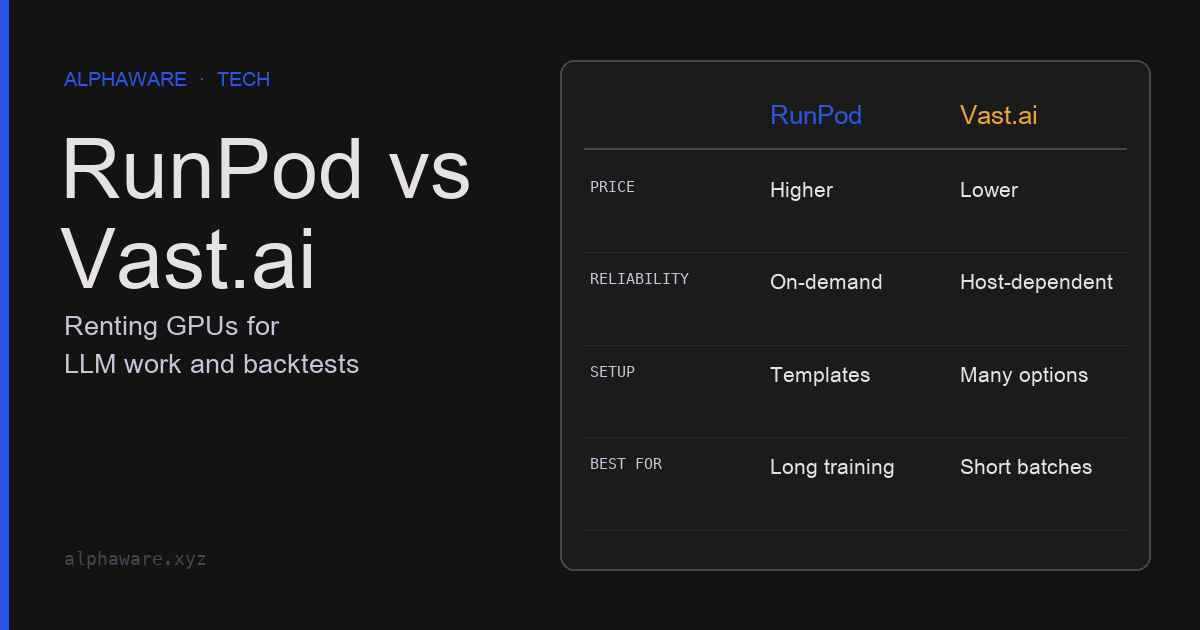
GPU 작업이 가끔 있다면 클라우드 임대가 먼저 검토 대상입니다. 비교 기준은 시간당 요금 하나가 아닙니다. 중단 가능 여부(온디맨드와 인터럽터블), 실행하지 않을 때도 붙는 스토리지 요금, 데이터 전송 요금, 최소 충전 조건을 합쳐 봐야 합니다. 서비스별 구조는 RunPod와 Vast.ai 비교 칼럼에 정리했습니다.
구매가 맞는 경우는 사용 시간이 길고 꾸준하거나, 데이터를 외부로 보낼 수 없는 경우입니다. 판단할 때는 장비 가격을 예상 사용 시간으로 나눈 값을 같은 사양의 임대 비용과 비교하고, 전력·유지보수·감가를 함께 넣습니다. 숫자는 구매 시점의 공식 가격과 실제 사용 기록으로 계산해야 하며, 이 글에서 대신 정해 줄 수 없습니다. 로컬 모델과 API 모델 자체의 선택은 로컬 LLM과 클라우드 모델 비교를 참고하세요.
→ RunPod 가입하기 (레퍼럴 크레딧 적용)
자료와 적용 범위
- Apple Mac mini 사양, Mac Studio 사양: 칩 구성별 통합 메모리 용량과 대역폭.
- NVIDIA DGX Spark: GB10 사양, 메모리·대역폭, 모델 크기 제시값, FP4 성능 표기 조건, OEM 목록.
- NVIDIA GeForce RTX 5090, RTX 4090: 메모리, 메모리 인터페이스, 전력 사양.
- PyTorch MPS 백엔드 노트:
mps장치와 float64 미지원. - RunPod GPU 선택 가이드: 파라미터당 메모리 경험칙과 작업별 VRAM 범위.
- 이 글은 장비별 벤치마크를 직접 측정하지 않았고, 특정 제품 구매를 권하지 않습니다. 생성 속도 계산은 이론 상한일 뿐 실측값이 아닙니다.