업데이트: 2026년 11월 3일. 검증 분할 방법과 선택 편향을 다루는 방법 칼럼입니다. 코드와 숫자는 무작위로 만든 가상 데이터의 예시이며, 실제 전략의 투자 성과가 아닙니다.
좋은 백테스트 숫자는 시도 횟수와 함께 읽어야 한다
파라미터 조합 수백 개를 같은 기간에 돌린 뒤 가장 좋은 것을 고르면, 실제 우위가 없어도 그중 하나는 좋아 보이기 쉽습니다. Bailey, Borwein, López de Prado, Zhu(2014)는 시도한 구성의 수에 비해 과거 데이터가 충분하지 않으면, 백테스트에서 가장 좋아 보이는 구성이 표본의 우연한 극단에 맞춰질 수 있다고 지적합니다.
아래 예시는 기대수익이 0인 가상 전략 200개를 만들고, 앞 252개 관측에서 샤프 비율이 가장 높은 것을 고릅니다.
import numpy as np

rng = np.random.default_rng(7)
n_trials, n_is, n_oos = 200, 252, 252

# 기대수익이 0인 가상 전략 200개: 어떤 것도 실제 우위가 없다
returns = rng.normal(0.0, 0.01, size=(n_trials, n_is + n_oos))
is_ret, oos_ret = returns[:, :n_is], returns[:, n_is:]

def sharpe(r):
    return r.mean(axis=-1) / r.std(axis=-1, ddof=1)

is_sharpe = sharpe(is_ret)
best = int(np.argmax(is_sharpe))

# 샤프 추정치의 표준오차는 대략 1/sqrt(T) (관측 단위, 비연율화)
se = 1 / np.sqrt(n_is)
print(f"best in-sample SR: {is_sharpe[best]:.3f}, SE ~ {se:.3f}")
print(f"same strategy out-of-sample SR: {sharpe(oos_ret[best]):.3f}")

assert abs(is_sharpe.mean()) < se                # 평균적으로는 우위가 없다
assert is_sharpe[best] > 2 * se                  # 가장 좋은 것만 고르면 우위처럼 보인다
assert sharpe(oos_ret[best]) < is_sharpe[best]   # 같은 전략의 검증 구간 값은 떨어진다
이 시드에서는 선택된 전략의 인샘플 샤프가 표준오차의 약 2.8배였고, 이어지는 구간에서는 음수였습니다. 숫자 자체보다 구조가 중요합니다. 검증 분할을 아무리 잘 해도, 여러 후보 중 최고값을 고른 사실을 보정하지 않으면 결과가 과대평가됩니다.
Walk-forward는 운영 순서를 재현하지만 검증 구간이 적다
Walk-forward는 과거 구간으로 파라미터를 정하고, 바로 뒤 구간에서 평가한 뒤, 창을 앞으로 옮겨 반복합니다. 운영에서 실제로 일어나는 순서와 같다는 점이 장점입니다.
scikit-learn의 TimeSeriesSplit은 이 구조를 확장 창으로 제공합니다. k번째 분할에서 앞쪽 k개 fold를 학습에, 다음 fold를 검증에 쓰며, 학습 세트는 이전 분할의 학습 세트를 포함합니다. max_train_size로 학습 창 길이를 제한할 수 있고, gap은 각 학습 세트 끝에서 검증 세트 앞까지 제외할 표본 수입니다.
라벨이 미래 수익률이라면 gap을 라벨 기간 이상으로 두어야 학습 라벨이 검증 구간 시작 전에 모두 확정됩니다.
import numpy as np
from sklearn.model_selection import TimeSeriesSplit

n, horizon = 120, 5
start = np.arange(n)                          # 의사결정 시점 i
end = np.minimum(start + horizon, n - 1)      # 라벨이 확정되는 시점

tscv = TimeSeriesSplit(n_splits=4, test_size=20, gap=horizon)
for train_idx, test_idx in tscv.split(start):
    # gap이 라벨 기간 이상이면 학습 라벨은 검증 구간 시작 전에 모두 확정된다
    assert end[train_idx].max() < test_idx.min()
    assert train_idx.max() + horizon < test_idx.min()
단점은 데이터 소모입니다. 각 관측은 최대 한 번만 검증에 쓰이고, 앞쪽 구간은 검증에 쓰이지 않습니다. 검증 구간 수가 적으면 구간별 성과의 분산을 추정하기 어렵고, 특정 시장 국면 하나가 결과를 좌우할 수 있습니다.
라벨이 겹치면 시간순 분할만으로는 누수가 남는다
일반 K-Fold는 검증 fold 앞뒤의 데이터를 모두 학습에 씁니다. 금융 데이터에서 더 구체적인 문제는 라벨 구간의 중첩입니다. t 시점의 라벨이 t+1부터 t+5까지의 수익률이라면, 검증 구간 바로 앞의 학습 표본은 검증 구간과 같은 가격 움직임으로 라벨이 만들어집니다.
López de Prado의 Advances in Financial Machine Learning(2018) 7장은 두 장치를 제안합니다.
- Purging: 라벨 형성 구간이 검증 라벨 구간과 겹치는 학습 표본을 제거합니다. 단순히 “인접한 몇 개”가 아니라, 각 표본의 라벨 시작·종료 시점을 기준으로 판단합니다.
- Embargo: 검증 구간이 끝난 직후의 표본도 일정 길이만큼 학습에서 뺍니다. 특징값의 계열 상관처럼 라벨 중첩만으로 잡히지 않는 연결을 줄이기 위한 완충 구간입니다.
import numpy as np

def purged_kfold(start, end, n_splits=5, embargo=0):
    """라벨 구간 [start[i], end[i]]가 검증 구간과 겹치는 학습 표본을 제거하고,
    검증 라벨이 끝난 직후 embargo개 표본도 학습에서 뺀다."""
    idx = np.arange(len(start))
    for test_idx in np.array_split(idx, n_splits):
        test_start = start[test_idx].min()
        test_end = end[test_idx].max()
        overlap = (start <= test_end) & (end >= test_start)
        after = (start > test_end) & (start <= test_end + embargo)
        train_idx = idx[~overlap & ~after]
        yield train_idx, test_idx

n, horizon, embargo = 120, 5, 3
start = np.arange(n)
end = np.minimum(start + horizon, n - 1)

for train_idx, test_idx in purged_kfold(start, end, n_splits=5, embargo=embargo):
    t0, t1 = start[test_idx].min(), end[test_idx].max()
    # 1) 학습 라벨 구간과 검증 라벨 구간이 겹치지 않는다
    assert not np.any((start[train_idx] <= t1) & (end[train_idx] >= t0))
    # 2) 검증 라벨 종료 직후 embargo 구간도 학습에 없다
    assert not np.any((start[train_idx] > t1) & (start[train_idx] <= t1 + embargo))
    # 3) 검증 구간 뒤의 표본도 학습에 쓰인다: 시간순 분할과 다른 점
    if t1 + embargo < n - 1:
        assert start[train_idx].max() > t1
세 번째 조건이 이 방법의 성격을 보여 줍니다. Purged K-Fold는 검증 구간 이후의 데이터로도 학습합니다. 라벨 누수는 막지만, “당시 알 수 있었던 정보로만 학습했다”는 운영 재현은 아닙니다. 이 차이는 시장 구조가 시간에 따라 변할 때 결과 해석에 영향을 줍니다.
두 방법은 대체재가 아니라 다른 질문에 답한다
| 기준 | Walk-forward | Purged K-Fold |
|---|---|---|
| 답하는 질문 | 당시 순서대로 운영했다면 어땠는가 | 라벨 누수 없이 모델이 일반화되는가 |
| 검증 구간 수 | 적음, 각 관측은 최대 한 번 검증 | 많음, 모든 fold가 한 번씩 검증 |
| 미래 데이터로 학습 | 하지 않음 | 함, 검증 구간 이후 표본 포함 |
| 필요한 정보 | 학습 창 길이, gap |
표본별 라벨 시작·종료 시점, embargo 길이 |
| 주의할 점 | 국면 하나가 결과를 좌우할 수 있음 | 시간에 따른 구조 변화가 평균에 묻힐 수 있음 |
흔히 쓰는 순서는 Purged K-Fold로 모델과 하이퍼파라미터 후보를 좁히고, 마지막에 손대지 않은 최근 구간을 Walk-forward로 확인하는 것입니다. 다만 두 결과가 비슷하다고 과적합이 없다고 결론 내릴 수는 없습니다. 같은 데이터를 보며 후보를 계속 고쳤다면 두 검증 모두 그 선택 과정의 영향을 받습니다.
선택 편향은 분할 방법으로 해결되지 않는다
Bailey와 López de Prado(2014)의 Deflated Sharpe Ratio(DSR)는 두 가지 부풀림을 보정하려는 지표입니다. 여러 전략을 시험해 최고값을 고른 데서 오는 선택 편향, 그리고 수익률 분포가 정규분포가 아닌 데서 오는 왜곡입니다. 시험한 대안의 수가 늘면 운만으로 얻는 최고 샤프 비율의 기대값도 커진다는 것이 출발점입니다.
DSR을 계산하려면 시도 횟수와 시도들 사이 샤프 비율의 분산이 필요합니다. 따라서 공식보다 먼저 기록이 필요합니다.
- 시험한 파라미터 조합, 피처 세트, 기간 정의를 모두 남깁니다. 결과가 나빠 버린 것도 포함합니다.
- 서로 거의 같은 전략은 독립적인 시도로 세지 않도록 묶는 기준을 정합니다.
- 최종 후보를 고른 뒤에는 검증 구간을 다시 보며 규칙을 바꾸지 않습니다. 바꿨다면 그 사실도 시도 기록에 추가합니다.
성과표 전에 확인할 조건
다음은 결과를 믿기 전에 시험해 볼 조건입니다. 통과 기준은 결과를 보기 전에 정해 두는 편이 좋습니다.
- 인샘플과 아웃오브샘플의 차이: 검증 구간 성과가 크게 떨어지면 선택 편향이나 구조 변화를 의심합니다. 단일 구간 하나보다 여러 구간의 분포를 봅니다.
- 파라미터 민감도: 최적값 주변의 이웃 파라미터에서도 결과가 비슷한지 확인합니다. 한 점에서만 좋은 결과는 우연에 맞춰졌을 가능성이 큽니다.
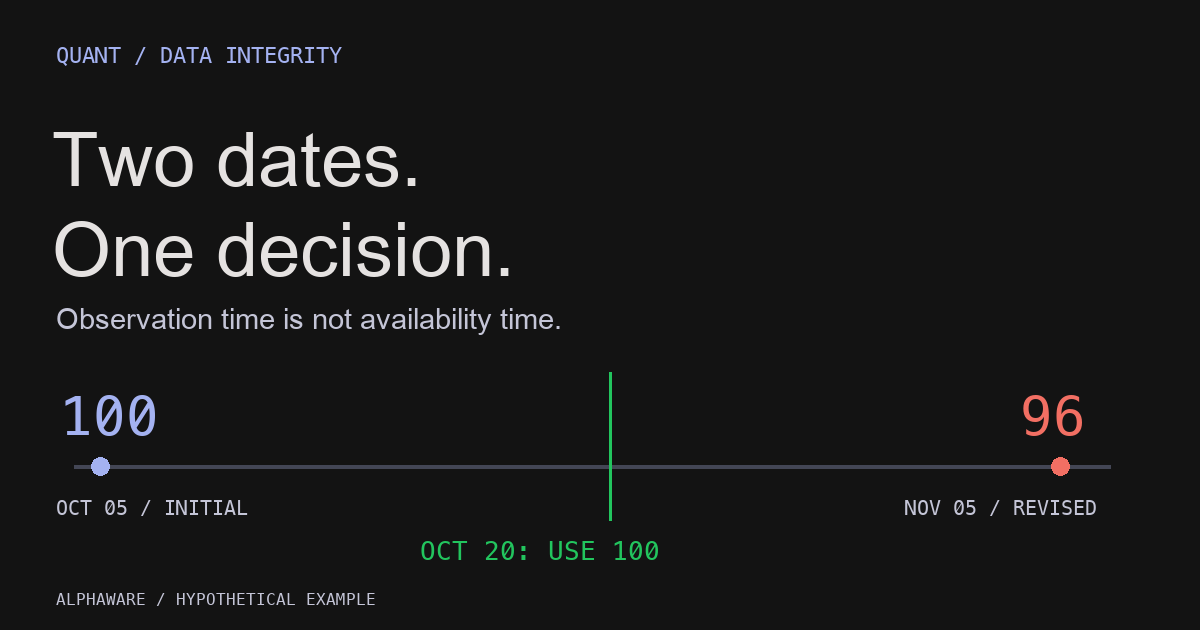
- 신호와 체결 시점: 종가로 만든 신호를 같은 종가에 체결하는 가정은 흔한 룩어헤드입니다. 신호가 확정되는 시각과 주문이 가능한 시각을 분리합니다.
- 데이터 이용 가능 시점: 수정 발표되는 지표는 당시 버전을 써야 합니다. 포인트인타임 데이터 칼럼에서 다룹니다.
- 거래 비용과 슬리피지: 회전율이 높은 전략일수록 비용 가정에 결과가 민감합니다. 비용을 바꿔 가며 결과가 어떻게 변하는지 봅니다.
자료와 적용 범위
- Bailey, Borwein, López de Prado, Zhu (2014), Notices of the AMS 61(5): 시도 수에 비해 데이터가 부족할 때의 백테스트 과적합.
- Bailey & López de Prado (2014), The Deflated Sharpe Ratio, Journal of Portfolio Management 40(5): 선택 편향과 비정규성을 보정하는 샤프 비율.
- López de Prado (2018), Advances in Financial Machine Learning, Wiley: 7장 금융 교차검증의 purging·embargo.
- scikit-learn TimeSeriesSplit: 확장 창 분할,
max_train_size,gap정의. - 이 글은 검증 절차를 설명할 뿐이며, 특정 분할 방법이나 점검 목록을 통과한 전략이 실전에서 수익을 낸다고 주장하지 않습니다.