작성 기준: 2026년 11월 2일. 데이터 설계 칼럼입니다. 아래 날짜·값은 원리를 설명하기 위한 가상 예시이며, 실제 경제지표 발표나 투자 성과를 재현한 결과가 아닙니다.
시계열을 과거부터 나눠도 미래 정보가 들어간다
경제지표를 내려받아 날짜순으로 정렬하고, 앞부분으로 학습한 뒤 뒷부분으로 검증했습니다. 무작위 분할도 하지 않았습니다. 그런데 이 절차만으로는 당시 매매할 수 있었던 전략인지 알 수 없습니다. 지금 내려받은 과거 값에 나중에 발표된 수정치가 들어갈 수 있기 때문입니다.
백테스트에 필요한 질문은 두 개입니다. 이 숫자는 어느 기간을 설명하는가. 그리고 의사결정 순간에 어떤 버전의 숫자를 알 수 있었는가. 첫 번째 날짜만 저장하면, 데이터는 과거를 가리키면서도 내용은 미래의 정보를 담게 됩니다.
ALFRED는 과거 특정 날짜에 이용할 수 있었던 경제지표 버전을 조회하는 빈티지 개념을 제공합니다. 관측일과 수정치가 유효했던 기간도 구분합니다. 이 구분이 필요한 이유는 단순합니다. 오늘의 가장 정확한 과거 기록과 당시의 정보 집합은 다릅니다. ALFRED 다운로드 안내
관측일, 발표 시각, 시스템 도착 시각
가상의 월간 지표를 생각해 봅시다. 단위는 임의의 지수 포인트입니다.
| 관측 대상 | 시스템 이용 가능 시각 | 값 | 버전 |
|---|---|---|---|
| 9월 | 10월 5일 13:00 UTC | 100 | 최초 발표 |
| 9월 | 11월 5일 13:00 UTC | 96 | 수정 발표 |
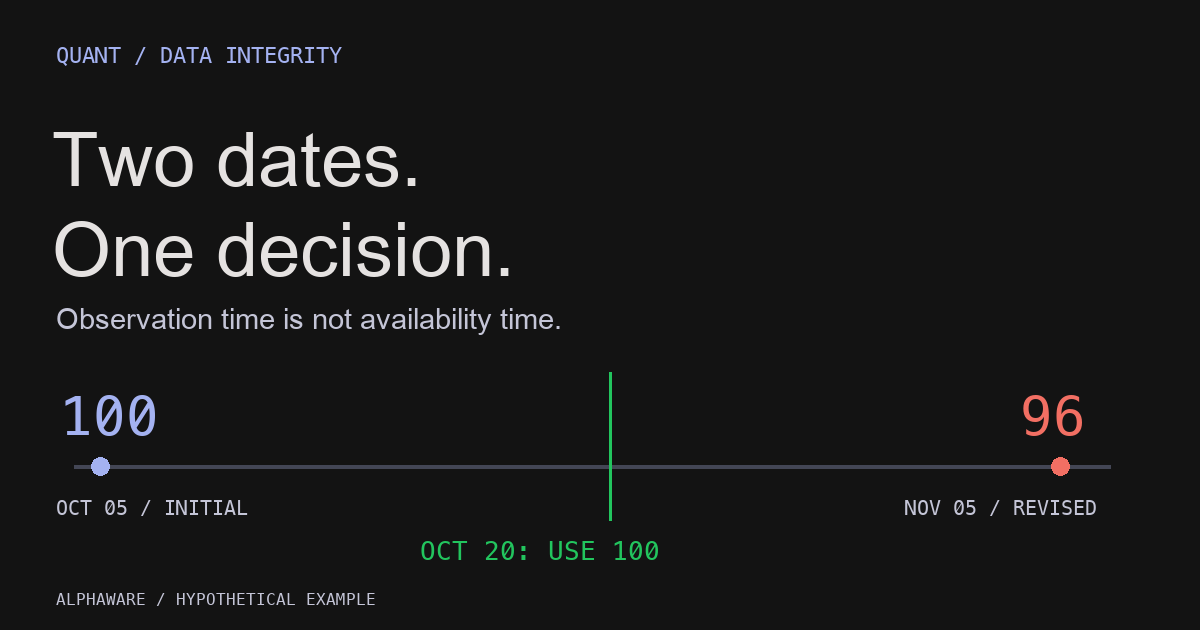
10월 20일의 전략은 100을 사용할 수 있지만, 96을 사용할 수는 없습니다. 10월 1일에는 두 값 모두 알 수 없습니다. 9월의 시장 수익률 옆에 관측월이 같다는 이유로 100이나 96을 붙이면 발표 전 정보까지 쓰는 셈입니다.
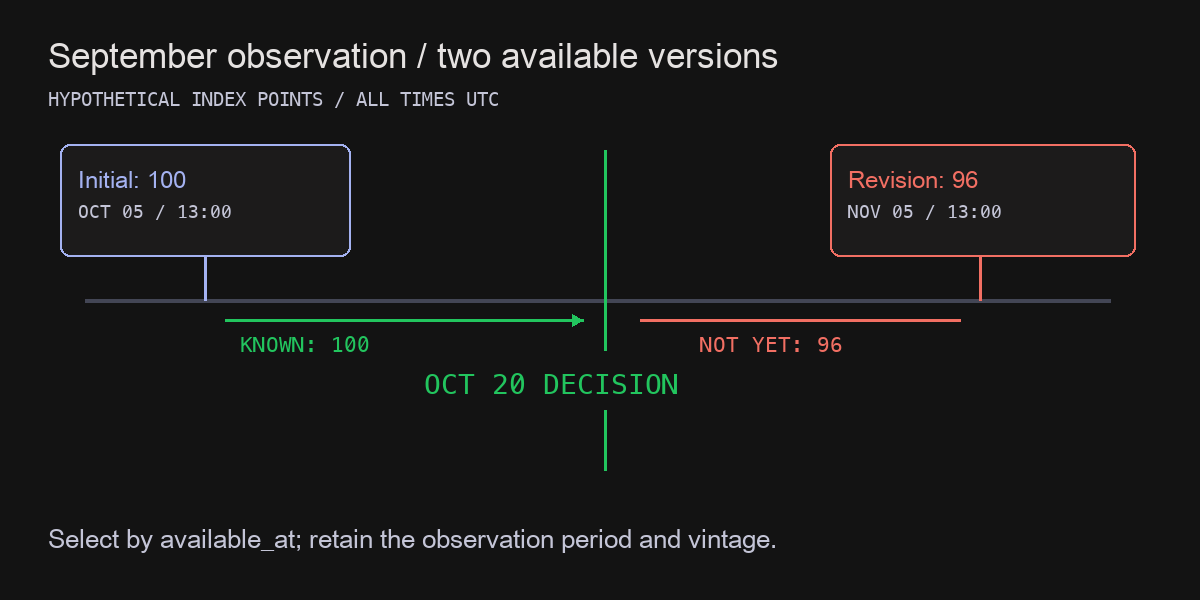
직접 그린 개념도. 숫자 100·96과 일정은 가상 값입니다. 10월 20일 의사결정에는 최초 발표 값만 들어갑니다.
발표 시각과 시스템 도착 시각도 같지 않을 수 있습니다. 공식 발표가 13:00이어도 공급자 지연과 수집·검증을 거쳐 13:02에 사용 가능해졌다면, 운영 재현에는 뒤의 시각이 필요합니다. 반대로 오늘 처음 내려받은 파일의 수신 시각을 10년 전 발표 시각으로 되돌려 쓰는 것도 부정확합니다. 역사적 도착 기록이 없다면 공식 발표 기록과 명시적인 지연 가정으로 재구성했다는 사실을 남겨야 합니다.
덮어쓰지 말고 버전을 쌓는다
최소 저장 단위는 날짜별 숫자 하나가 아니라 관측 기간별 버전 기록입니다.
| 필드 | 저장할 내용 |
|---|---|
series_id, observation_period |
지표와 측정 대상 기간 |
value, unit, adjustment |
값, 단위, 계절조정 등 변환 기준 |
source_released_at |
확인 가능한 공식 발표 시각과 시간대 |
available_at |
해당 버전을 전략이 이용할 수 있는 시각 |
vintage_id |
공급자가 구분하는 데이터 버전 |
retrieved_at, source_hash |
실제 수집 시각과 원본 파일 해시 |
available_at은 공급자 원본 필드가 아닐 수도 있습니다. 발표 시각, 지연 가정, 실제 시스템 로그 가운데 무엇으로 만들었는지 함께 기록합니다. 수정치가 와도 기존 값을 지우지 않아야 같은 의사결정을 다시 실행할 수 있습니다.
ALFRED의 빈티지 날짜 목록은 새 값이나 수정이 발생한 날짜를 제공하지만, 값이 변하지 않은 발표일은 목록에서 빠질 수 있습니다. 따라서 이를 완전한 발표 일정표로 취급하면 안 됩니다. FRED 빈티지 날짜 API 설명
또한 일 단위 빈티지만으로 분 단위 발표 이벤트를 재현할 수는 없습니다. 장중 전략이라면 원 발표기관의 시각과 당시 공급 경로를 별도로 확인하거나, 정확한 시각이 없는 데이터를 보수적으로 다음 의사결정부터 사용하는 규칙이 필요합니다.
조인은 관측월이 아니라 이용 가능 시점으로 제한한다
다음 예시는 한 지표·한 관측 기간에 대한 버전을 고릅니다. 실제 데이터셋에서는 지표와 관측 기간별로 적용하고, 단위·계절조정 기준도 먼저 맞춰야 합니다.
from datetime import datetime

def dt(text):
    return datetime.fromisoformat(text)

versions = [
    {"available_at": dt("2026-10-05T13:00:00+00:00"), "value": 100},
    {"available_at": dt("2026-11-05T13:00:00+00:00"), "value": 96},
]

def value_asof(rows, decision_at):
    known = [r for r in rows if r["available_at"] <= decision_at]
    if not known:
        return None
    return max(known, key=lambda r: r["available_at"])["value"]

assert value_asof(versions, dt("2026-10-01T00:00:00+00:00")) is None
assert value_asof(versions, dt("2026-10-20T00:00:00+00:00")) == 100
assert value_asof(versions, dt("2026-11-06T00:00:00+00:00")) == 96
동일 시각에 서로 다른 값이 두 개 들어오면 이 코드는 우선순위를 판단하지 못합니다. 운영에서는 충돌을 오류로 처리하거나 출처 우선순위를 명시해야 합니다. 경계의 <=도 입력이 실제로 사용 가능한 순간이라는 가정 아래에서만 맞습니다. 종가 확정 뒤 생성한 신호를 같은 종가에 체결시키는 것은 별도의 실행 누수입니다.
이 조인은 데이터 이용 가능성만 다룹니다. 학습 구간에서만 전처리를 적합하는지, 수익률 라벨 구간이 검증 구간과 겹치는지, 주문이 언제 체결되는지는 여전히 따로 검증해야 합니다. 기존 과적합 방지 칼럼의 검증 분할과 함께 적용할 문제입니다.
수익률보다 먼저 확인할 세 가지 불변 조건
첫째, 미래 버전을 추가해도 과거 결정의 입력은 같아야 합니다. 11월 수정치를 데이터베이스에 넣었다고 10월 20일 신호가 달라지면 재현 경계가 깨진 것입니다. 원본과 변환 코드가 같다는 조건에서, 당시 선택한 버전 ID와 피처 해시를 비교할 수 있습니다.
둘째, 미발표는 0이 아닙니다. 아직 발표되지 않은 값을 0으로 채우면 경제 상태에 대한 새로운 가정을 넣습니다. 결측을 허용할지, 해당 신호를 보류할지, 이전에 알려진 관측치를 얼마나 오래 쓸지 미리 정해야 합니다. 오래된 값을 이어 쓴다면 데이터 나이도 피처나 품질 기록으로 남깁니다.
셋째, 재계산 시점의 유니버스도 고정해야 합니다. 경제지표 빈티지를 관리해도 현재 살아 있는 종목만 과거에 적용하면 생존편향이 남습니다. 수정 주가, 기업행동, 상장폐지, 구성종목 변경은 각 공급자의 의미를 확인해야 하며 하나의 빈티지 필드로 모두 해결되지 않습니다.
처음부터 전략을 다시 최적화할 필요는 없습니다. 한 번의 기존 의사결정을 골라 입력 파일, 당시 선택한 버전, 지연 가정, 신호 생성과 체결 시각을 복원해 보세요. 설명할 수 없는 시간이 발견되면, 성과표보다 먼저 데이터 계약을 고치는 편이 순서에 맞습니다.
자료와 적용 범위
- ALFRED 다운로드 도움말: 빈티지와 관측일·실시간 유효기간의 의미.
- FRED 빈티지 날짜 API: 변경이 없었던 발표일은 빈티지 목록에 없을 수 있다는 제약.
- 저장 스키마, 지연 가정, 검증 불변 조건은 이 글에서 제안한 구현 원칙입니다. 실증 수익률 개선을 측정하거나 특정 전략의 유효성을 주장하지 않습니다.